Плановете за AI центрове за данни: много от тях може никога да не бъдат построени
TechCrunch съобщава, че много обявени проекти за AI центрове за данни може никога да не бъдат построени, още преди да се стигне до разрешителни, местна съпротива и недостиг на електроенергия. За екипите, които продават дигитални продукти, това превръща изчислителния капацитет от сигурност в допускане при планиране.
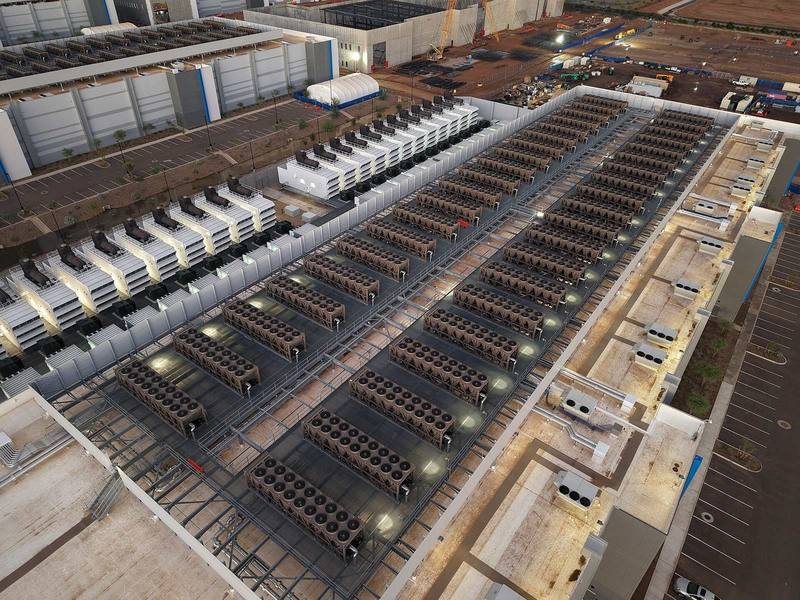
На 11 ноември TechCrunch съобщи, че бумът на AI центрове за данни се сблъсква с практически пречки: местна съпротива, забавяния при разрешителните и конкуренция за електроенергия. Изданието добавя и по-фундаментален момент: голяма част от обявяваните проекти може изобщо да не бъдат построени, още преди да се стигне до тези препятствия. В репортажа не се уточнява колко проекта са засегнати, кои региони са най-изложени и каква част от обявения капитал се очаква да се превърне в работещи съоръжения.
Тази несигурност е от значение отвъд инфраструктурния сектор. Обявеният капацитет не е същото като наличния капацитет и именно разликата между двете е това, около което дигиталните бизнеси трябва да планират.
Защо обявеният капацитет не е основа за планиране
Всяко обявяване на ново AI съоръжение подхранва едно подразбиращо се допускане: че изчислителната мощ ще поевтинява и ще става по-достъпна по предвидим график. Ако значителна част от тези проекти зациклят, това допускане отслабва. В репортажа не се казва кои проекти са най-застрашени, така че в момента никой не може да съпостави разликата с конкретен доставчик или регион. Известно е, че посочените ограничения са локални и се развиват бавно: спорове за ползване на земя, одобрения, присъединяване към електропреносната мрежа. Никое от тях не се решава в рамките на един продуктов план.
За екипите, които изграждат решения върху AI, практическата последица е, че планирането на капацитета трябва да се основава на това, което е договорено и доставено, а не на това, което е обявено. Ангажиментите за цени и наличност от страна на доставчиците заслужават същото внимание, както всяка друга зависимост от доставчик.
Какво да следят маркетинг екипите в собствения си стек
Повечето екипи за привличане на трафик и монетизация не купуват центрове за данни, но потребяват това, което излиза от тях: inference на модели, системи за препоръки, оптимизация на реклами, аналитика. Излагането е косвено и лесно се пропуска, докато цената не се промени или дадена функция не бъде ограничена.
Няколко проверки си струва да се направят тази седмица:
- Направете списък на функциите във фунията, които зависят от AI – от таргетиране през персонализация до автоматизация на поддръжката – и отбележете на кой доставчик или модел разчита всяка от тях.
- Попитайте доставчиците какви ангажименти за капацитет стоят зад цените им и дали тези ангажименти са договорни или само прогнозни.
- Моделирайте сценарий, при който разходите за inference остават същите или се покачват, вместо да падат, и вижте кои кампании или ценови нива спират да имат смисъл.
- Запазете ръчна или базирана на правила резервна опция за една-две автоматизации, от които приходите ви зависят най-много.
Нищо от това не изисква да предвиждате кои проекти ще бъдат построени. Изисква само да откажете да приемате евтината изчислителна мощ като гарантиран ресурс.
По-широкият сигнал
В репортажа не се измерва разликата между обявената и доставената инфраструктура и не се дава график за това как ще се реши ситуацията. Това, което той подсказва, е, че физическите ограничения на AI се превръщат в бизнес променлива, а не във фонов тренд. За основателите и маркетинг ръководителите полезната позиция е скучна: документирайте зависимостите, поставяйте под въпрос обещанията на доставчиците и калкулирайте възможността капацитетът, на който всички разчитат, да дойде по-късно, в по-малък обем или изобщо да не дойде.
Прочетете също
-
Франция: Макрон атакува AI чатботове и умни играчки в името на децата
Еманюел Макрон иска забрана на определени приложения на изкуствения интелект, когато те застрашават деца, като посочва чатботове и умни играчки, съобщава Siècle Digital. Обявеното не уточнява обхват, срокове и механизъм за прилагане, затова екипите, чиято аудитория включва и по-млади потребители, трябва да следят какво следва.
-
Забавяния на разрешителни и съпротива: реалният капацитет за AI
TechCrunch съобщава, че местна съпротива, забавяния на разрешителни и ограничения на електрозахранването забавят проектите за дата центрове и че голяма част от обявените строежи може никога да не се реализират. За екипите, които разчитат на AI, това променя планирането на капацитет и разходи.
-
Orange обединява OpenAI, Google, Anthropic и Mistral в едно приложение
Orange пусна нова версия на приложението си, достъпна за всички потребители, включително клиенти на други оператори, която събира моделите на OpenAI, Google, Anthropic и Mistral в един интерфейс. Обявлението не уточнява цени, лимити за ползване или как се разпределят заявките между доставчиците.